

 製作品
 73
[#SPRESENSE 2026]簡単だけど奥が深いにょ[日本語入力]
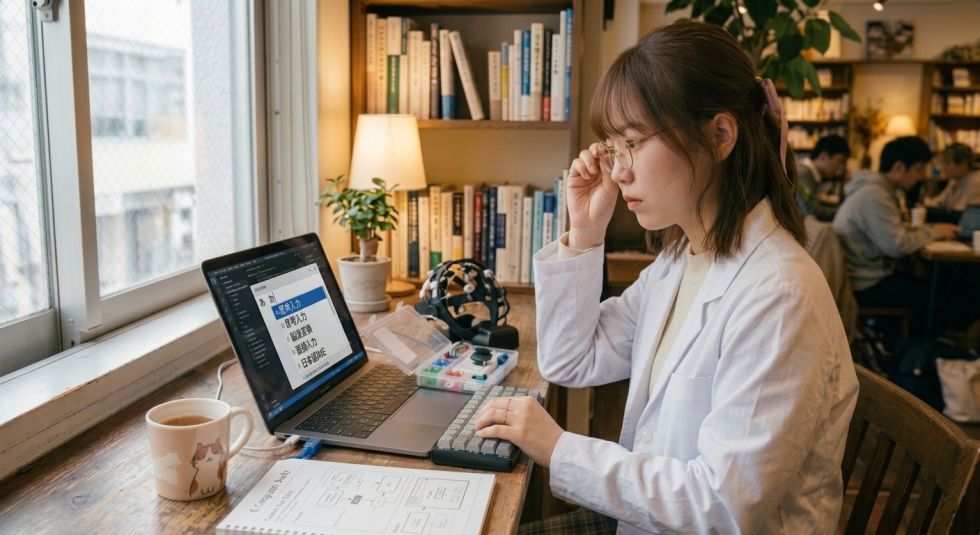
Spresenseのハンドヘルド端末に、自作の日本語入力(ローマ字→ひらがな→SKK辞書変換)を載せた
はじめに
Spresenseで作っているハンドヘルド端末(HandHeld / spreHPC.ino)に、日本語入力を載せました。
ローマ字をひらがなに直し、スペースキーでSKK辞書を引いて漢字候補を出す、という小さなIMEです。
この記事では、そのIME(ime.hpp)の中身を、SKK辞書の扱いまで含めてできるだけ細かく書きます。
私が「簡単な変換でよい」と割り切って何を削ったのか、その結果どんな癖が残っているのかも、動きを追って確認したことをそのまま書きます。
この記事でわかること
- ローマ字→ひらがな変換の仕組み(最長一致・促音・「ん」の扱い)
- SKK辞書(SKK-JISYO)の形式と、Spresenseで使うための準備
- SDカードの辞書を内蔵フラッシュへコピーして検索する仕組み
Imeクラスの状態遷移とAPI- 現状の制限と、今後FEP形式にするかどうか迷っていること
1. 作ったもの
ime.hpp は、ヘッダ1枚(約490行)で完結する日本語入力エンジンです。
| 機能 | 内容 |
|---|---|
| ローマ字→ひらがな | テーブル引き(3文字→2文字→1文字の最長一致) |
| 促音・撥音 | 同子音の連続で「っ」、n+子音で「ん」 |
| 漢字変換 | 辞書の見出し語に完全一致した候補を出す(スペースで次候補) |
| 辞書 | ①SDカード上のSKK辞書(既定) ②コード内蔵の小さな配列辞書 |
| 辞書の置き場所 | SDの辞書を内蔵フラッシュにコピーして、そちらを検索する(切替可) |
切替はマクロで行います。
#define IME_USE_SD_DICT        1   // 1: SKK辞書(SD)  0: 内蔵配列辞書
#define IME_CACHE_DICT_TO_FLASH 1  // 1: 内蔵フラッシュにコピーして使う  0: 毎回SDを検索
2. なぜ自作したのか(私の考え)
正直に言うと、私は「ちゃんとした日本語入力」を作りたかったわけではありません。
HandHeldでメモを書けるだけの日本語入力があればよかったのです。
だから方針は最初から決めていました。
- 漢字変換は簡単なものでよい
- 辞書は**メモリ(組込み側)**で持てるものにしたい
この2つを守ると、文節解析や学習、活用語の処理は全部捨てることになります。
その代わり、コードは小さく、動きを全部自分で追えます。
私にとっては「動きが全部わかる」ことのほうが、変換精度よりずっと大事でした。
辞書は、自分で単語を打ち込んでいく方式では続かないと思い、既存の SKK辞書 を使うことにしました。
SKK辞書はテキスト形式で構造が単純で、「1行読んで見出しを比べる」だけで引けるので、小さなマイコンでも扱えます。
3. 環境
- ボード: Spresense(Arduino)
- ディスプレイ: ILI9488(320×480)、ライブラリは LovyanGFX
- キーボード: CH9350経由のUSB HIDキーボード(JISレイアウト)
- 辞書: microSDカード(SDHCIライブラリ)、内蔵SPIフラッシュ(
/mnt/spif)
4. 全体構成
キーボード(CH9350)
        │  1文字ずつ
        ▼
 ┌───────────────────────────────┐
 │ Ime クラス                    │
 │  romajiBuf ──(テーブル引き)──▶ kanaBuf │
 │                     │         │
 │             henkan()│         │
 │                     ▼         │
 │             lookupKanji()     │
 │                     │         │
 │          ┌──────────┴───────┐ │
 │          ▼                  ▼ │
 │   SKK辞書(フラッシュ/SD)  内蔵配列辞書 │
 └───────────────────────────────┘
        │  currentText() / confirm()
        ▼
   画面(LovyanGFX)に表示
エンジン側は「文字を1つ食わせる」「変換する」「確定する」「1文字消す」だけを持ちます。
画面への描画やキー入力の読み取りは持たず、呼び出し側(spreHPC.ino)の仕事です。
5. ローマ字→ひらがな変換
5.1 変換テーブル
変換テーブルは、ローマ字とかなの組を並べた単純な配列です。
struct RomajiEntry {
  const char* romaji;
  const char* kana;
};

static const RomajiEntry romajiTable[] = {
  // 拗音・特殊 (3文字)
  {"kya","きゃ"},{"kyu","きゅ"},{"kyo","きょ"},
  {"sha","しゃ"},{"shu","しゅ"},{"sho","しょ"},
  {"sya","しゃ"},{"syu","しゅ"},{"syo","しょ"},
  ...
  {"chi","ち"}, {"shi","し"}, {"tsu","つ"},

  // 清音 (2文字)
  {"ka","か"},{"ki","き"},{"ku","く"},{"ke","け"},{"ko","こ"},
  ...
  // 母音 (1文字)
  {"a","あ"},{"i","い"},{"u","う"},{"e","え"},{"o","お"},
};同じ音を複数の打ち方で受けたかったので、別のローマ字を同じかなに割り当てる形にしています。
| かな | 受け付ける打ち方 |
|---|---|
| し | si / shi |
| ち | ti / chi |
| つ | tu / tsu |
| ふ | hu / fu |
| じ | zi / ji |
| しゃ | sya / sha |
| ちゃ | tya / cha |
| じゃ | zya / jya |
検索は先頭から順に比べる線形探索です。テーブルは百数十件なので、キー1回ごとに引いても困りません。
inline const char* lookupRomaji(const char* romaji, int len) {
  for (int i = 0; i < romajiTableSize; i++) {
    if ((int)strlen(romajiTable[i].romaji) == len &&
        strncmp(romajiTable[i].romaji, romaji, len) == 0) {
      return romajiTable[i].kana;
    }
  }
  return nullptr;
}長さも比較するのがポイントです。strncmp だけだと "k" が "ka" の先頭に一致してしまいます。
5.2 最長一致
feedRomaji(c) に文字が1つ渡されるたびに、romajiBuf(最大4文字)の末尾から3文字、2文字、1文字の順で表を引きます。
for (int len = 3; len >= 1; len--) {
  if (romajiLen < len) continue;
  const char* kana = lookupRomaji(romajiBuf + (romajiLen - len), len);
  if (kana) {
    appendKana(kana);
    return true;
  }
}
kyo と打つ流れは次のとおりです。
| 入力 | romajiBuf | 引いた結果 | kanaBuf |
|---|---|---|---|
k |
k |
1文字 k はない |
(空) |
y |
ky |
2文字 ky、1文字 y はない |
(空) |
o |
kyo |
3文字 kyo がある → きょ |
きょ |
appendKana() は、かなを足すと同時に romajiBuf を空にします。
5.3 促音「っ」
同じ子音が2つ続いたら「っ」を出し、後ろの子音は次の入力として残します。
if (romajiLen == 2 && romajiBuf[0] == romajiBuf[1] &&
    strchr("aiueon", romajiBuf[0]) == nullptr) {
  appendKana("っ");
  romajiBuf[0] = c;
  romajiBuf[1] = 0;
  romajiLen = 1;
  return true;
}
kka なら、k,k で「っ」を出して k が残り、a で「か」になり、「っか」ができます。
母音と n は除外しています(nn を「っ」にしないため)。
5.4 撥音「ん」
「ん」は2か所で作ります。
(a) n の次に、母音でも y でもない子音が来たとき
if (romajiLen == 2 && romajiBuf[0] == 'n' &&
    strchr("aiueoy", romajiBuf[1]) == nullptr) {
  char next = romajiBuf[1];
  appendKana("ん");
  romajiBuf[0] = next;
  ...
}
kanka なら、n の次に k が来た時点で「ん」を確定し、k を次の入力として続けます。
(b) 語尾の n
kaban のように n で終わる語では、n が保留のまま残ります。
henkan() や confirm() の先頭で flushPendingN() を呼び、保留中の n を「ん」として吐き出します。
void flushPendingN() {
  if (romajiLen == 1 && romajiBuf[0] == 'n') {
    appendKana("ん");
  }
}
5.5 コードを追って分かった癖
「簡単な版」と割り切って作ったので、いくつか癖が残っています。動きを1文字ずつ追って確認したものだけを書きます。
① 表にない組み合わせは、子音が黙って消える
末尾から3→2→1文字で引くので、表にない組み合わせでも、最後の1文字が母音なら1文字の表に当たります。
jaと打つと、jが消えて 「あ」 になる(表にjaがないため)xa/la(小さい「ぁ」のつもり)も同様に 「あ」 になる
jya / zya は表にあるので「じゃ」は出ます。ja ju jo は表に足せば済む話で、私の中では最初に直す候補です。
② nn は「ん」と、保留中の n を残す
nn の2つ目の n で、(a) の条件に当たって「ん」が出ます。ただし2つ目の n は次の入力として残るので、次に母音が来れば「な」行になります。
konnichiha は「こんにちは」になります。一方、語尾で kann と打つと「かんん」になります(保留の n が最後にもう1つ「ん」になる)。
語尾の「ん」は、n を1回だけ打ってからスペースで変換する運用にしています。
③ 使えない入力
- 大文字、数字、記号、
-(長音「ー」)、句読点はfeedRomaji()がfalseを返す(=IMEでは処理しない)ので、呼び出し側でそのまま表示する n'は使えない- 変換中(後述の
IME_HENKAN)は、ローマ字入力を受け付けずにfalseを返す - 未確定のローマ字(
romajiBuf)はprivateで、外から見るための関数がない。「k」だけ打った状態を画面に出せない
6. 漢字変換とSKK辞書
6.1 SKK辞書とは
SKKは、ローマ字入力と辞書引きを中心にした日本語入力方式です。その辞書ファイルが SKK-JISYO.* で、テキストで配布されています。
配布されている主な種類は、大きさが小さい順に S M L などです。Lは数MB規模なので、マイコンではSから試すのが現実的でした(このコードのコメントも SKK-JISYO.S を例にしています)。
6.2 ファイル形式
1行が1エントリで、見出し語 + 空白 + /候補1/候補2/.../ です。
きょう /今日/京/
かわ /川/河/革/- 行頭が
;の行はコメント(ヘッダ) - 候補の後ろに
;を付けて注釈を書けることがある(例:/候補;注釈/) - 文字コードは配布元では EUC-JP。そのままではUTF-8の
ime.hppでは使えない
辞書は「送り仮名あり」と「送り仮名なし」の2つの区画に分かれています。;; okuri-ari entries. と ;; okuri-nasi entries. というコメント行が目印です。
「送り仮名あり」側は、かk のように見出しの末尾に活用の子音が付いた形で、動詞・形容詞の活用語尾のために使われます。
6.3 入手とUTF-8への変換
ime.hpp は UTF-8 を前提にしているので、事前に変換します(コードのコメントにも書いてある手順です)。
nkf -w SKK-JISYO.S > SKK-JISYO.utf8できた SKK-JISYO.utf8 を、SDカードのルートに置きます。ファイル名を変えるなら、kanjiDictBegin("ファイル名") で指定します。
6.4 起動時の流れ(フラッシュ・キャッシュ有効時)
IME_CACHE_DICT_TO_FLASH が1(既定)のとき、kanjiDictBegin() は次の順に動きます。
theSD.begin()でSDを初期化- SDの辞書を内蔵フラッシュ
/mnt/spif/SKK-JISYO.utf8へコピー(すでにあればスキップ) - フラッシュ側のファイルを
fopenして、以後はそちらを検索
inline bool kanjiDictBegin(const char* path = "SKK-JISYO.utf8") {
  if (!theSD.begin()) return false;
  if (!copyDictSdToFlash(path, DICT_FLASH_PATH)) return false;
  dictFile = fopen(DICT_FLASH_PATH, "rb");
  return dictFile != nullptr;
}
コピー本体は、512バイトずつ読んで書くだけです。
uint8_t buf[512];
int n;
bool ok = true;
while ((n = src.read(buf, sizeof(buf))) > 0) {
  if (fwrite(buf, 1, n, dst) != (size_t)n) { ok = false; break; }
}
キャッシュにした理由(私の判断)
- 一度コピーしてしまえば、SDカードを抜いても変換できる(HandHeldは持ち歩く端末なので、これが大きい)
- SDのファイルを1バイトずつ読むより、内蔵フラッシュを
fgetcで読むほうが扱いやすいと考えた
注意点
- 「すでにあればスキップ」はファイルの有無だけを見ています。サイズも中身も比べません。辞書を差し替えたいときは、フラッシュ側のファイルを消すか、
DICT_FLASH_PATHを変える必要があります(ime.hppに消す関数は入れていません) - 内蔵フラッシュはSDより容量がずっと小さいので、大きな辞書は入りません。その場合は辞書を削って小さくします
- コピー途中で失敗すると、中途半端なファイルがフラッシュに残ります(次回起動では「すでにある」と判断されます)
6.5 検索の仕組み
検索は、毎回ファイルの先頭から1行ずつ読んで、見出し語が完全一致する行を探す線形探索です。
inline uint8_t lookupKanji(const char* kana, const char** outCand, uint8_t maxCand) {
  if (!dictFile) return 0;
  fseek(dictFile, 0, SEEK_SET);

  size_t kanaLen = strlen(kana);

  while (readDictLine(dictLineBuf, DICT_LINE_MAX)) {
    if (dictLineBuf[0] == ';') continue;          // コメント行

    char* sp = strchr(dictLineBuf, ' ');
    if (!sp) continue;
    size_t midashiLen = sp - dictLineBuf;
    if (midashiLen != kanaLen || strncmp(dictLineBuf, kana, kanaLen) != 0) continue;
...- 1行の読み取りは
fgetcの1文字ずつ。\nで行終わり、\rは読み捨て(CRLFの辞書でも動く) - 行バッファは
DICT_LINE_MAX = 256バイト。それを超える分は捨てる - 見出しは「先頭から最初の空白まで」。長さが違えば
strncmpの前に弾く
6.6 候補の取り出し
一致した行の空白から後ろを、別のバッファ dictCandBuf にコピーし、/ で区切って候補を切り出します。
strncpy(dictCandBuf, sp + 1, DICT_LINE_MAX - 1);
dictCandBuf[DICT_LINE_MAX - 1] = 0;

uint8_t n = 0;
char* p = dictCandBuf;
if (*p == '/') p++;
while (*p && n < maxCand) {
  char* slash = strchr(p, '/');
  if (!slash) break;
  *slash = 0;
  char* semi = strchr(p, ';');   // ; 以降は注釈なので捨てる
  if (semi) *semi = 0;
  outCand[n++] = p;
  p = slash + 1;
}
return n;
ポイントは3つです。
outCandはdictCandBufの中を指すポインタで、文字列をコピーしていません。メモリを節約できる反面、次にlookupKanji()を呼ぶと前の候補は壊れます- 候補は最大
IME_MAX_CAND = 8個まで - 注釈(
;以降)は、表示に使わず捨てる
6.7 このコードが扱わないSKKの機能
「簡単な変換」と決めたので、次は最初から入れていません。
| SKKの機能 | 本実装 |
|---|---|
| 送り仮名あり(動詞・形容詞の活用) | 非対応。かk のような見出しは引かない。「書く」は変換できない |
| 単語登録・学習 | なし(辞書は読み取り専用) |
| 文節・連文節変換 | なし(打った文字列全体を1つの見出しとして引く) |
| 部分一致・前方一致 | なし(完全一致のみ) |
(concat ...) などの特殊な候補表記 |
非対応(そのまま文字列として出る) |
| 5個目以降を一覧で出す表示 | なし(スペースで1つずつ巡回) |
さらに、次の点は実装の都合による制限です。
- 256バイトを超える行の末尾は切れる。候補が多い長い行では、切れた最後の候補は(後ろに
/がないので)取り出されずに落ちます - 「送り仮名あり」の区画がファイルの前半にあるので、毎回そこを読み飛ばしてから「送り仮名なし」に入る。大きい辞書ほど、変換のたびの待ち時間が伸びる
6.8 SDを毎回検索するモード
IME_CACHE_DICT_TO_FLASH を0にすると、フラッシュにコピーせず、SDの File を毎回シークして検索します。
検索の流れ(行を読む→見出しを比べる→候補を切る)は同じで、ファイルの開き方と読み方(theSD.open / dictFile.read())だけが違います。
フラッシュを消費したくないときや、辞書をよく入れ替えて試すときには、こちらが楽でした。
6.9 内蔵の配列辞書
IME_USE_SD_DICT を0にすると、SDを使わず、コードに埋め込んだ39語の辞書で動きます。
struct KanjiEntry {
  const char* kana;       // 見出し(ひらがな)
  const char* kanji[4];   // 候補(最大4、残りは nullptr)
};

static const KanjiEntry kanjiDict[] = {
  {"わたし",   {"私", nullptr}},
  {"きょう",   {"今日", nullptr}},
  {"かわ",     {"川", "革", nullptr}},
  {"き",       {"木", "気", nullptr}},
  ...
};SDカードがない状態での動作確認や、辞書の準備ができていないときの代わりに使えます。インターフェース(kanjiDictBegin() と lookupKanji())がSKK版と同じなので、Ime クラスは辞書の種類を意識しません。
6.10 辞書のライセンスについて
SKK-JISYO.* は辞書ごとにライセンスが決まっています(GPL系が中心のはずです)。
辞書ファイルを自分のリポジトリや記事に同梱する前に、配布元の記載を必ず確認してください。私はこの記事に辞書そのものは載せていません。
7. Ime クラス
7.1 バッファのサイズ
#define IME_MAX_ROMAJI 4    // ローマ字バッファ
#define IME_MAX_KANA   64   // ひらがな見出しの最大バイト数(UTF-8)
#define IME_MAX_CAND 8 // 変換候補の最大数ひらがな1文字はUTF-8で3バイトなので、IME_MAX_KANA = 64 は約21文字が上限です。
1回の変換で入力できる長さは、メモ用途なら足りると判断しました。
7.2 API
| 関数 | 役割 |
|---|---|
bool feedRomaji(char c) |
小文字 a〜z を1文字食わせる。IMEが消費すれば true、対象外なら false |
void henkan() |
スペースキー用。1回目は辞書を引き、2回目以降は次の候補へ(最後の次は先頭に戻る) |
const char* currentText() |
いま画面に出すべき文字列(変換中は選択中の候補、そうでなければひらがな) |
bool isComposing() |
入力中(かなまたはローマ字が残っている)か |
const char* confirm() |
Enter用。確定文字列を返して内部状態をクリア |
void backspace() |
1文字消す(変換中は候補選択の取り消し) |
void clear() |
全部捨てる |
void flushPendingN() |
保留中の n を「ん」にする |
7.3 状態遷移
状態は IME_INPUT(入力中)と IME_HENKAN(変換中)の2つだけです。
henkan()
   ┌──────────────────────────────┐
   │                              ▼
IME_INPUT                     IME_HENKAN ◀─┐
   ▲   │ feedRomaji()              │  │    │ henkan()
   │   └──(かなが溜まる)            │  └────┘ (次の候補へ)
   │                               │
   └───────── backspace() ─────────┘
              (候補選択を取り消してひらがなに戻る)

confirm() … どちらの状態からでも確定して IME_INPUT の空状態へIME_INPUTでhenkan()すると、辞書を引いてIME_HENKANに移る- 候補が0件でも
IME_HENKANに移る。このときcurrentText()は元のひらがなを返す IME_HENKANのbackspace()は文字を消さず、IME_INPUTに戻るだけ(ひらがなはそのまま残る)IME_HENKANのfeedRomaji()はfalseを返す。次の文字を打つ前にconfirm()で確定する運用が前提
7.4 呼び出し側の対応
呼び出し側(spreHPC.ino)のキーの割り当ては、次のとおりです。
| キー | 呼ぶ関数 |
|---|---|
a〜z |
feedRomaji(c)。false なら通常の文字として扱う |
| Space | isComposing() が真なら henkan()。偽なら通常のスペース |
| Enter | isComposing() が真なら confirm() の返り値を挿入。偽なら通常の改行 |
| Backspace | isComposing() が真なら backspace()。偽なら通常の削除 |
描画は、入力中は currentText() を画面の入力位置に出し、確定したら confirm() の文字列を本文に足す、という流れです。
確定文字列は confirm() 内の static バッファに入っています。次に confirm() を呼ぶまでしか有効ではないので、受け取ったらすぐ本文へコピーします。
8. 実機
9. 制限と今後
いま分かっている制限を、私の直したい順に書きます。
jajujoが「あ」等になる(表にないため)。拡張音(fawiなど)、小書き(xaltu)、長音-も未対応- 未確定のローマ字を画面に出せない。
romajiBufを読む関数を足せば済む - 送り仮名あり(動詞・形容詞)が変換できない。SKK辞書の「送り仮名あり」区画を使う仕組みが必要
- 辞書が大きいと待たされる。毎回先頭からの線形探索なので、索引かバイナリサーチを考えたい
- 辞書の差し替えがしにくい。「フラッシュにあればコピーしない」が有無だけの判定なので
FEP形式にするかどうか(検討中)
いまの ime.hpp は、アプリが自分でキーを渡す IME(組込み型) です。
一方、私が別に作っているLinaX(Spresense上のCインタプリタOS)では、edit.hpp やシェル、その上で動くCのプログラムが、同じキーボードから文字を読みます。
そこで、キーボードと標準入力の間に、FEP(フロントエンドプロセッサ)として1枚挟む案を考えています。
| 形式 | 良い点 | 気になる点 |
|---|---|---|
| IME(アプリ組込み) | 今のコードのまま使える | アプリごとに組み込みが必要 |
| FEP(端末層) | 各アプリは無改造で日本語入力できる | ON/OFF切替、未確定文字列の表示位置、確定文字列の渡し方を決める必要がある |
FEPにするなら、必要になるのは次の3つだと考えています。
- ON/OFFの切替キー。いまの
feedRomaji()は小文字a〜zを常に消費するので、OFFのときに英字を素通しにする仕組みがない - 未確定文字列の表示先(画面の最下行にするか、カーソル位置にするか)
- 確定文字列の渡し方(標準入力のバッファに積むか、コールバックで渡すか)
ime.hpp はエンジンとして、どちらの形式でもそのまま使える作りにしてあります。まだどちらにするか決めていません。
10. まとめ
- ローマ字→ひらがなは、テーブルの最長一致と、促音・撥音の2つの特例だけで動く
- 漢字変換は、SKK辞書を完全一致で引くだけ。文節・学習・活用は捨てた
- SKK辞書はUTF-8に変換してSDに置き、内蔵フラッシュへコピーして使う。コピー後はSDを抜いても動く
- 「簡単な変換でよい」と割り切ったおかげで、全部で約490行、動きを1文字ずつ追える大きさに収まった
- そのぶん癖や制限も残っているので、それは正直に書いた
最後まで読んでいただき、ありがとうございました。
投稿者の人気記事


-
chrmlinux03
さんが
前の土曜日の13:51
に
編集
をしました。
(メッセージ: 初版)
-
chrmlinux03
さんが
前の土曜日の13:52
に
編集
をしました。
-
chrmlinux03
さんが
前の土曜日の14:01
に
編集
をしました。
-
chrmlinux03
さんが
前の土曜日の14:14
に
編集
をしました。
-
chrmlinux03
さんが
前の土曜日の14:35
に
編集
をしました。
ログインしてコメントを投稿する